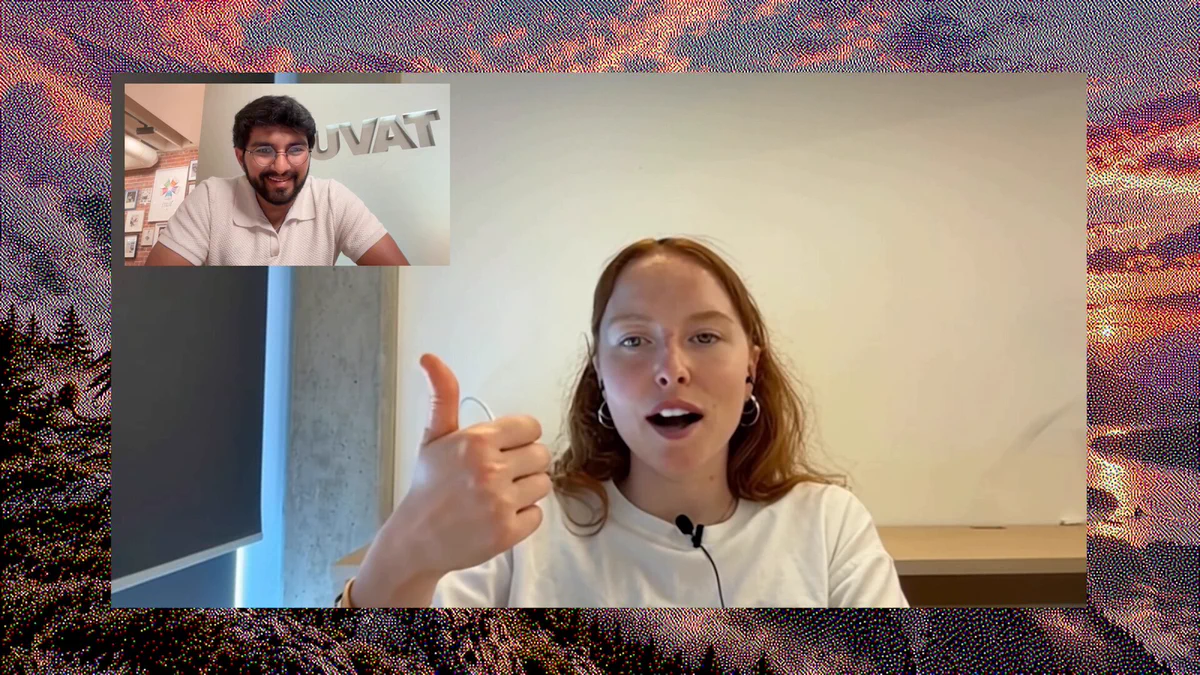
Компания Tavus представила модель Griffin, которая в реальном времени одновременно анализирует видео и аудио собеседника, говорит и реагирует на его мимику, жесты и паузы. В ходе тестирования 48% участников после минутного разговора считали, что общались с человеком, а не искусственным интеллектом.
Разработчики называют Griffin первой моделью, прошедшей так называемый видеотест Тюринга. В настоящее время система доступна только ограниченной группе тестировщиков в формате исследовательского превью.
Griffin построена как полнодуплексная система video-to-video. Она может одновременно слушать и говорить, распознавать взгляд, мимику и жесты, реагировать на продолжительность пауз, видеть предметы перед камерой и учитывать их в разговоре.
Tavus показывала возможности модели во время игры Simon Says, работы с кубиком Рубика и паяльником. В одном из тестов Griffin также интегрировала в разговор изображение павлина, попавшего в поле зрения камеры.
Система состоит из двух основных компонентов: Continuous Conversational Modeling, определяющего момент и способ ответа, и Audio-Visual Generation, генерирующего вещание и видео.
В тестировании NVIDIA VideoFDB версия Griffin-Lite заняла первое место среди 15 моделей. На графических процессорах H100 она генерировала 720p-видео фрагментами по 320 мс со средней задержкой 0,43 секунды.
Наиболее показательным стал тест с участием 54 человек. 26 участников, или 48%, после минутного видеоразговора решили, что общались с реальным человеком. Для предыдущей системы Tavus этот показатель составил 2,4%.
В то же время, Tavus пока не открывает модель для широкого использования. Компания заявляет, что работает над безопасным раскрытием присутствия ИИ и дополнительной оценкой рисков, поскольку способность системы убедительно выдавать себя за человека может создавать новые угрозы.
Читайте также
Подписывайтесь на Парламент UA в Telegram и Facebook и читайте самые важные и свежие новости первыми!
Читайте Parlament.UA в Google News.
Поделиться новостью


Нашли ошибку в тексте? Выделите ее и нажмите CTRL+ENTER.