Фото з відкритих джерел
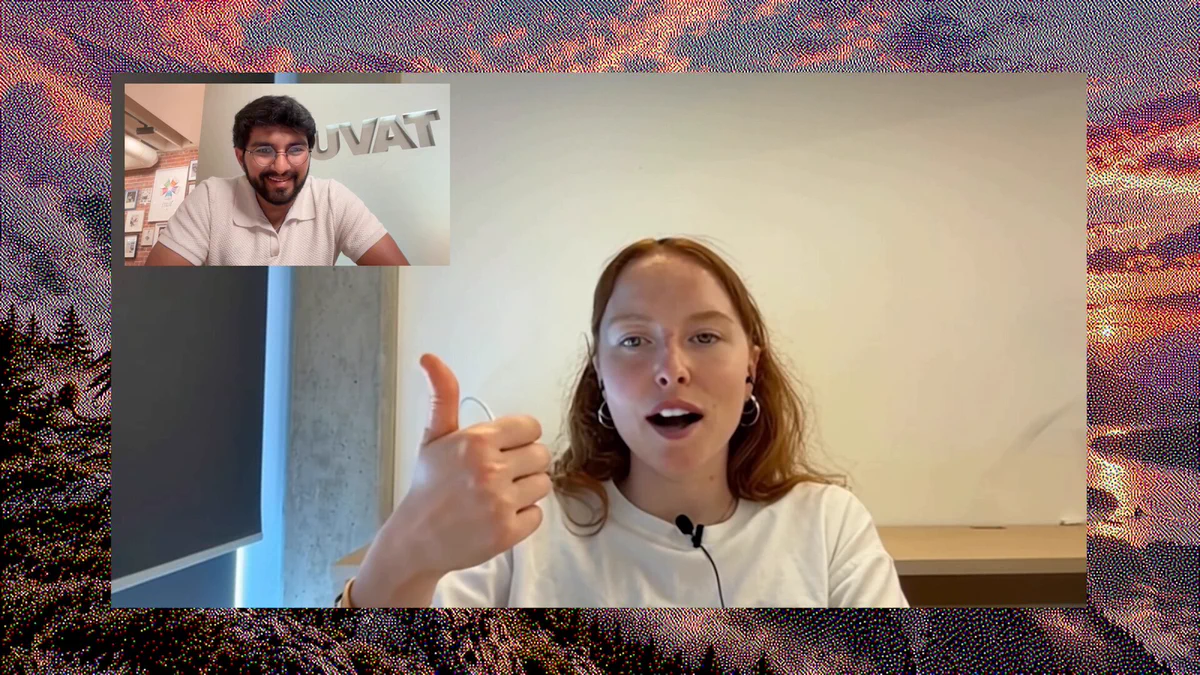
Компанія Tavus представила модель Griffin, яка в реальному часі одночасно аналізує відео та аудіо співрозмовника, говорить і реагує на його міміку, жести та паузи. Під час тестування 48% учасників після хвилинної розмови вважали, що спілкувалися з людиною, а не штучним інтелектом.
Розробники називають Griffin першою моделлю, яка пройшла так званий відеотест Тюрінга. Наразі система доступна лише обмеженій групі тестувальників у форматі дослідницького прев’ю.
Griffin побудована як повнодуплексна система video-to-video. Вона може одночасно слухати та говорити, розпізнавати погляд, міміку й жести, реагувати на тривалість пауз, бачити предмети перед камерою та враховувати їх у розмові.
Tavus демонструвала можливості моделі під час гри Simon Says, роботи з кубиком Рубіка та паяльником. В одному з тестів Griffin також інтегрувала в розмову зображення павича, який потрапив у поле зору камери.
Система складається з двох основних компонентів: Continuous Conversational Modeling, що визначає момент і спосіб відповіді, та Audio-Visual Generation, який генерує мовлення і відео.
У тестуванні NVIDIA VideoFDB версія Griffin-Lite посіла перше місце серед 15 моделей. На графічних процесорах H100 вона генерувала 720p-відео фрагментами по 320 мс із середньою затримкою 0,43 секунди.
Найбільш показовим став тест за участю 54 людей. 26 учасників, або 48%, після хвилинної відеорозмови вирішили, що спілкувалися з реальною людиною. Для попередньої системи Tavus цей показник становив 2,4%.
Водночас Tavus поки не відкриває модель для широкого використання. Компанія заявляє, що працює над безпечним розкриттям присутності ШІ та додатковою оцінкою ризиків, оскільки здатність системи переконливо видавати себе за людину може створювати нові загрози.
Читайте також
Читайте Parlament.UA в Google News.
Поділитися новиною


Знайшли помилку в тексті? Виділіть її та натисніть CTRL + ENTER.